World Wide Web
Dokumente durch Adressen und Links verbunden
Inhalt
- 1Browser als Client
- 2Adresse der Ressource
- 3HTTP-Anfrage
- 4Server mit HTML-Dokument
- 5Antwort an den Browser
Das World Wide Web verbindet Dokumente durch Links, denen ein Browser folgt. Tim Berners-Lee schlug es 1989 am CERN vor. Adressen, ein Übertragungsprotokoll und eine Dokumentensprache bilden seine Grundlage. Die 1990 lauffähigen Programme erschlossen Informationen auf unterschiedlichen Rechnern.
Was es ist
Das Web ist ein System aus Dokumenten und anderen Ressourcen, die über Adressen miteinander verbunden sind. Ein Link führt von einer Seite zu einer anderen, die auch auf einem anderen Rechner liegen kann. Der Browser stellt das Dokument dar und macht seine Links auswählbar. Ein Server liefert die angeforderten Ressourcen. So lassen sich verstreute Informationen lesen, ohne für jeden Rechner eigene Befehle zu lernen.
Das Internet ermöglicht die Kommunikation zwischen Netzen. Das Web ergänzt gemeinsame Regeln, um Informationen zu adressieren, anzufordern und darzustellen. Auch E-Mails nutzen das Internet, allerdings mit anderen Regeln. Eine Webseite kann Text, Bilder und Links enthalten. Eine Suchmaschine hilft beim Auffinden von Seiten; wer eine Adresse kennt, kann sie unmittelbar aufrufen.
Wie es funktioniert
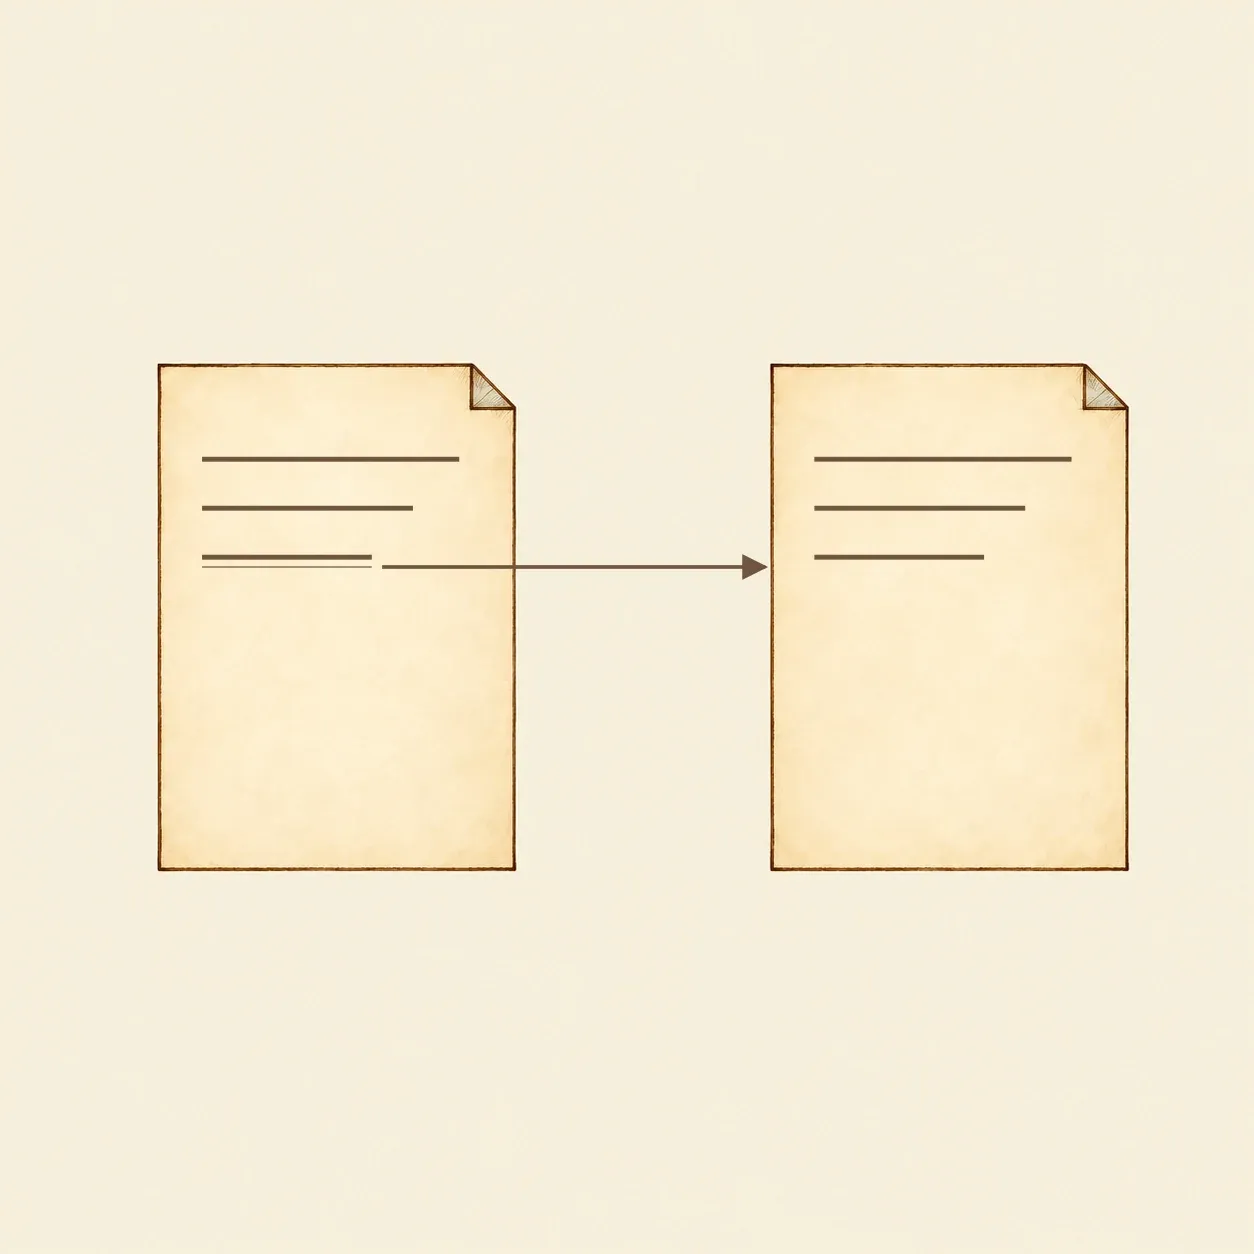 Ein Link verbindet eine sichtbare Textstelle mit der Adresse einer anderen Ressource.
Eine URL gibt an, wie eine Ressource erreichbar ist. Eine einfache HTTP-Adresse enthält das Protokoll, den Namen des Hosts und einen Pfad. Was dieser Pfad bezeichnet, bestimmt der Server. Dahinter muss keine tatsächlich so benannte Datei liegen. Ein Link kann eine vollständige Adresse enthalten oder eine relative Referenz, die anhand der Adresse des Ausgangsdokuments aufgelöst wird.
HTTP regelt den Austausch zwischen Client und Server. Der Browser sendet eine Anfrage; die Methode GET fordert eine Darstellung der bezeichneten Ressource an. Der Server antwortet mit einem Status, Angaben zum Inhalt und gegebenenfalls dem Inhalt selbst. Bei dem 1996 beschriebenen HTTP/1.0 steht 200 für Erfolg und 404 für eine nicht gefundene Ressource. Der Status sagt nichts darüber aus, ob der Inhalt sachlich stimmt.
HTML gliedert Dokumente durch Auszeichnungen. Überschriften und Absätze haben eigene Elemente. Das Element a enthält einen Link, dessen Ziel im Attribut href steht. Der Browser wertet diese Struktur aus und stellt sie dar. Der anklickbare Text kann anders lauten als die zugehörige Adresse. Die übertragenen Dokumentdaten und die sichtbare Bildschirmseite erfüllen daher unterschiedliche Aufgaben.
So geht’s
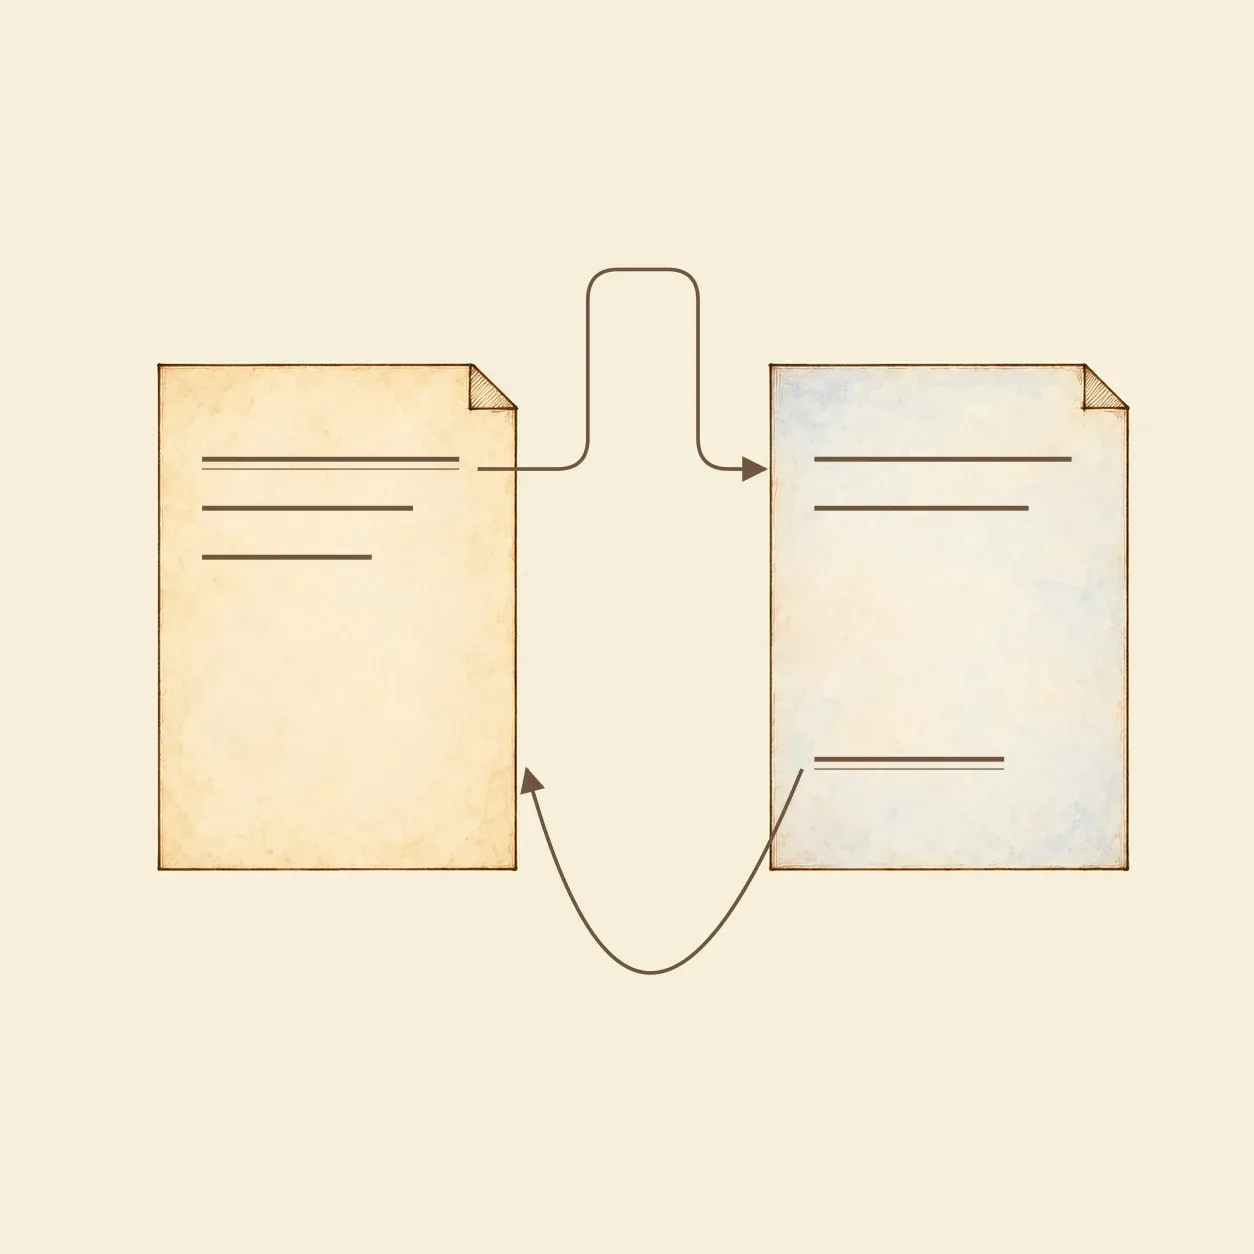 Mit zwei lokalen Dokumenten lassen sich Links in beide Richtungen ausprobieren.
Für den Versuch genügen ein Browser und ein einfacher Texteditor. Legen Sie in einem Ordner die Dateien a.html und b.html an. Speichern Sie reinen Text und behalten Sie die Dateiendung .html bei. Die erste Datei erhält diesen Inhalt:
<!doctype html>
<meta charset="utf-8">
<title>A</title>
<p>A <a href="b.html">B</a></p>
Ersetzen Sie in der zweiten Datei A durch B, das Linkziel durch a.html und den sichtbaren Linktext durch A. Öffnen Sie a.html im Browser. Folgen Sie B und anschließend A zurück. Tragen Sie danach absent.html als Ziel ein: Nun findet der Browser die Datei nicht. Stellen Sie den ursprünglichen Namen wieder her und laden Sie die Seite neu.
Hier liest der Browser lokale Dateien über eine file:-Adresse. Dabei findet kein HTTP-Austausch statt. Zeichnen Sie diesen gesondert auf Papier: eine Anfrage vom Client zum Server, eine Antwort zurück zum Client und darin das HTML-Dokument. Der Link im Dokument, die ausgelöste Anfrage und die empfangenen Daten bleiben dabei als getrennte Schritte erkennbar.
Geschichte und Entwicklung
Verknüpfte Texte gab es vor dem Web. Vannevar Bush beschrieb 1945 das Memex-Konzept; später entwickelten Doug Engelbart und Ted Nelson Ideen und Systeme für Hypertext. Berners-Lee schrieb 1980 am CERN ENQUIRE, um Informationen zu verknüpfen. Diese Arbeiten gehören zur Vorgeschichte verteilter Dokumente.
Im März 1989 schlug er dem CERN ein Informationssystem mit Links vor. Robert Cailliau wirkte 1990 an einem überarbeiteten Vorschlag mit. Berners-Lee programmierte auf einem NeXT den Browser samt Editor WorldWideWeb und einen Server. Ende des Jahres ließen sich die Programme vorführen. Nicola Pellow entwickelte einen Textbrowser für weitere Rechnertypen; im August 1991 wurden das Projekt und seine Dateien in öffentlichen Internet-Newsgroups angekündigt.
Mosaic erleichterte 1993 den grafischen Zugang. Am 30. April desselben Jahres machte das CERN seine Websoftware frei nutzbar. 1994 wurde das W3C gegründet, um gemeinsame Spezifikationen zu entwickeln. Formate und Protokolle wurden weiterentwickelt; adressierbare Dokumente und ihre Verknüpfungen blieben tragende Bestandteile.