World Wide Web
Documentos unidos por direcciones y enlaces
Contenido
- 1Navegador cliente
- 2Dirección del recurso
- 3Petición HTTP
- 4Servidor y documento HTML
- 5Respuesta al navegador
La World Wide Web enlaza documentos que se recorren con un navegador. Tim Berners-Lee la propuso en el CERN en 1989, reuniendo direcciones, un protocolo de intercambio y un lenguaje de documentos. Los programas operativos de 1990 permitieron consultar información repartida entre ordenadores distintos.
Qué es
La Web es un sistema de documentos y otros recursos conectados mediante direcciones. Un enlace lleva de una página a otra, que puede estar almacenada en otro ordenador. El navegador presenta el documento y permite seleccionar sus enlaces. Un servidor entrega los recursos solicitados. Así se consulta información dispersa sin tener que aprender los comandos particulares de cada máquina.
Internet proporciona la comunicación entre redes. La Web añade reglas comunes para localizar, pedir y presentar información. El correo electrónico también utiliza Internet, con otros protocolos. Una página web puede contener texto, imágenes y enlaces. Un buscador ayuda a encontrar páginas, aunque basta conocer una dirección para acceder a ella directamente.
Cómo funciona
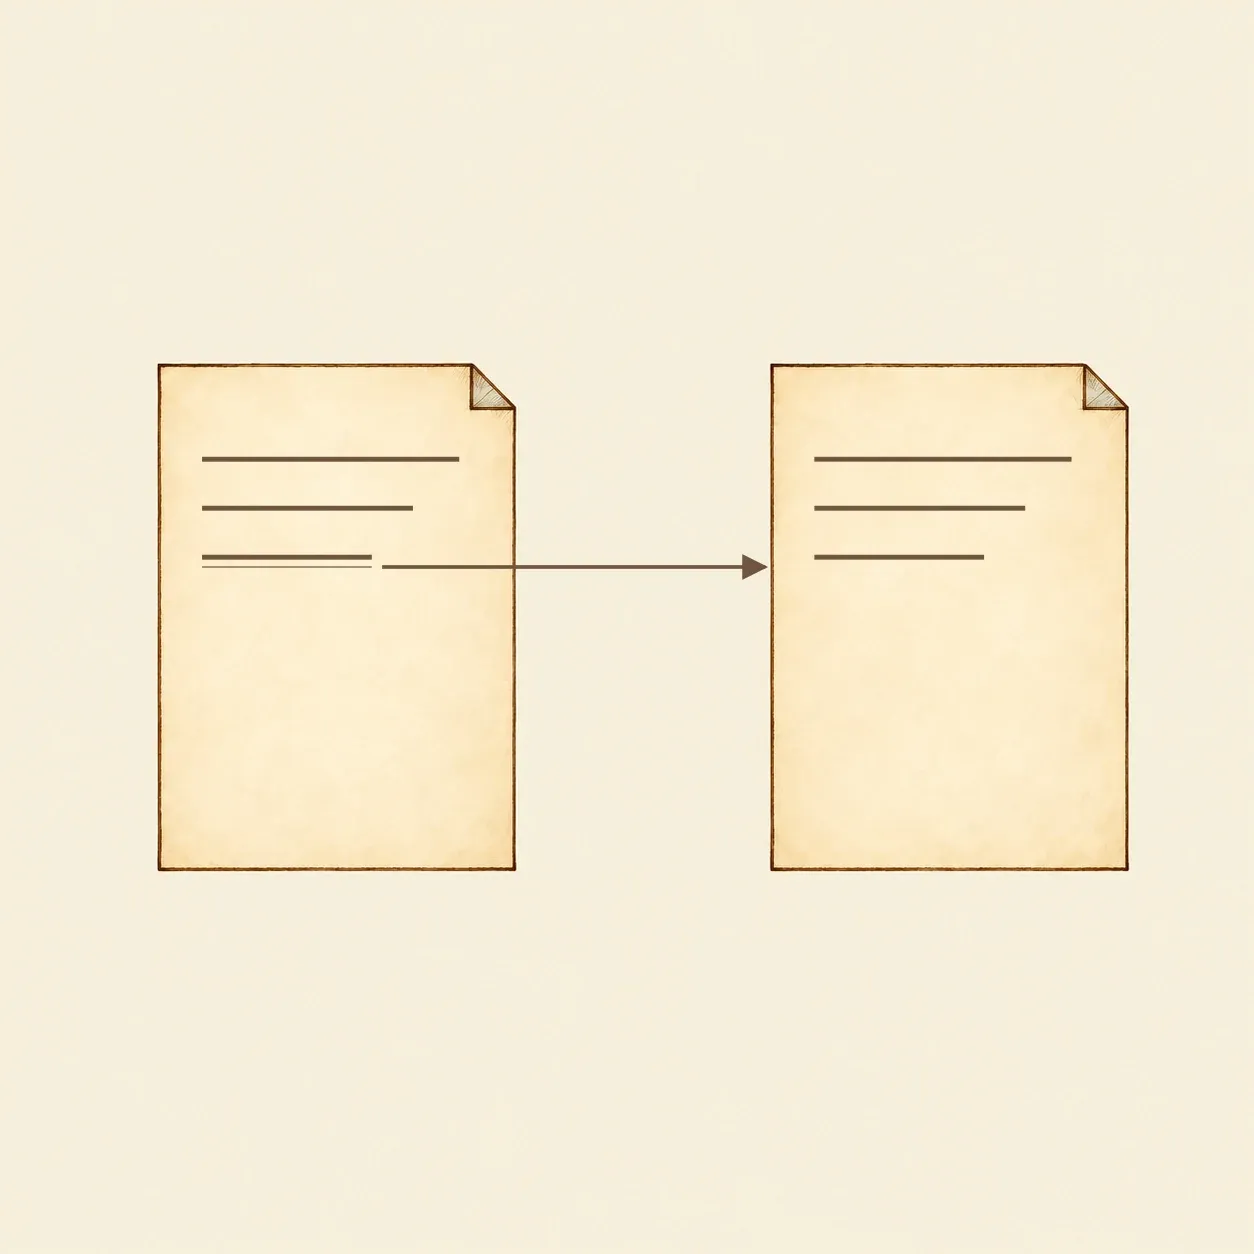 Un enlace asocia un pasaje visible con la dirección de otro recurso.
Una URL indica cómo llegar a un recurso. En una dirección HTTP sencilla aparecen el protocolo, el nombre del servidor y una ruta. El servidor determina qué significa esa ruta; no tiene por qué corresponder a un archivo físico. El enlace puede incluir una dirección completa o una referencia relativa que se resuelve a partir de la dirección del documento de origen.
HTTP organiza el intercambio entre cliente y servidor. El navegador envía una petición; el método GET solicita una representación del recurso indicado. El servidor devuelve un estado, información sobre el contenido y, cuando corresponde, el propio contenido. En HTTP/1.0, descrito en 1996, el código 200 indica éxito y 404 que no se ha encontrado el recurso. Estos códigos describen el intercambio, no la veracidad de la información recibida.
HTML estructura el documento mediante etiquetas. Los títulos y los párrafos tienen elementos propios. El elemento a contiene un enlace y su atributo href señala el destino. El navegador interpreta esa estructura para mostrarla. Las palabras sobre las que se pulsa pueden ser distintas de la dirección que ocultan. Los datos transferidos y la página visible en pantalla cumplen funciones diferentes dentro de la consulta.
Cómo hacerlo
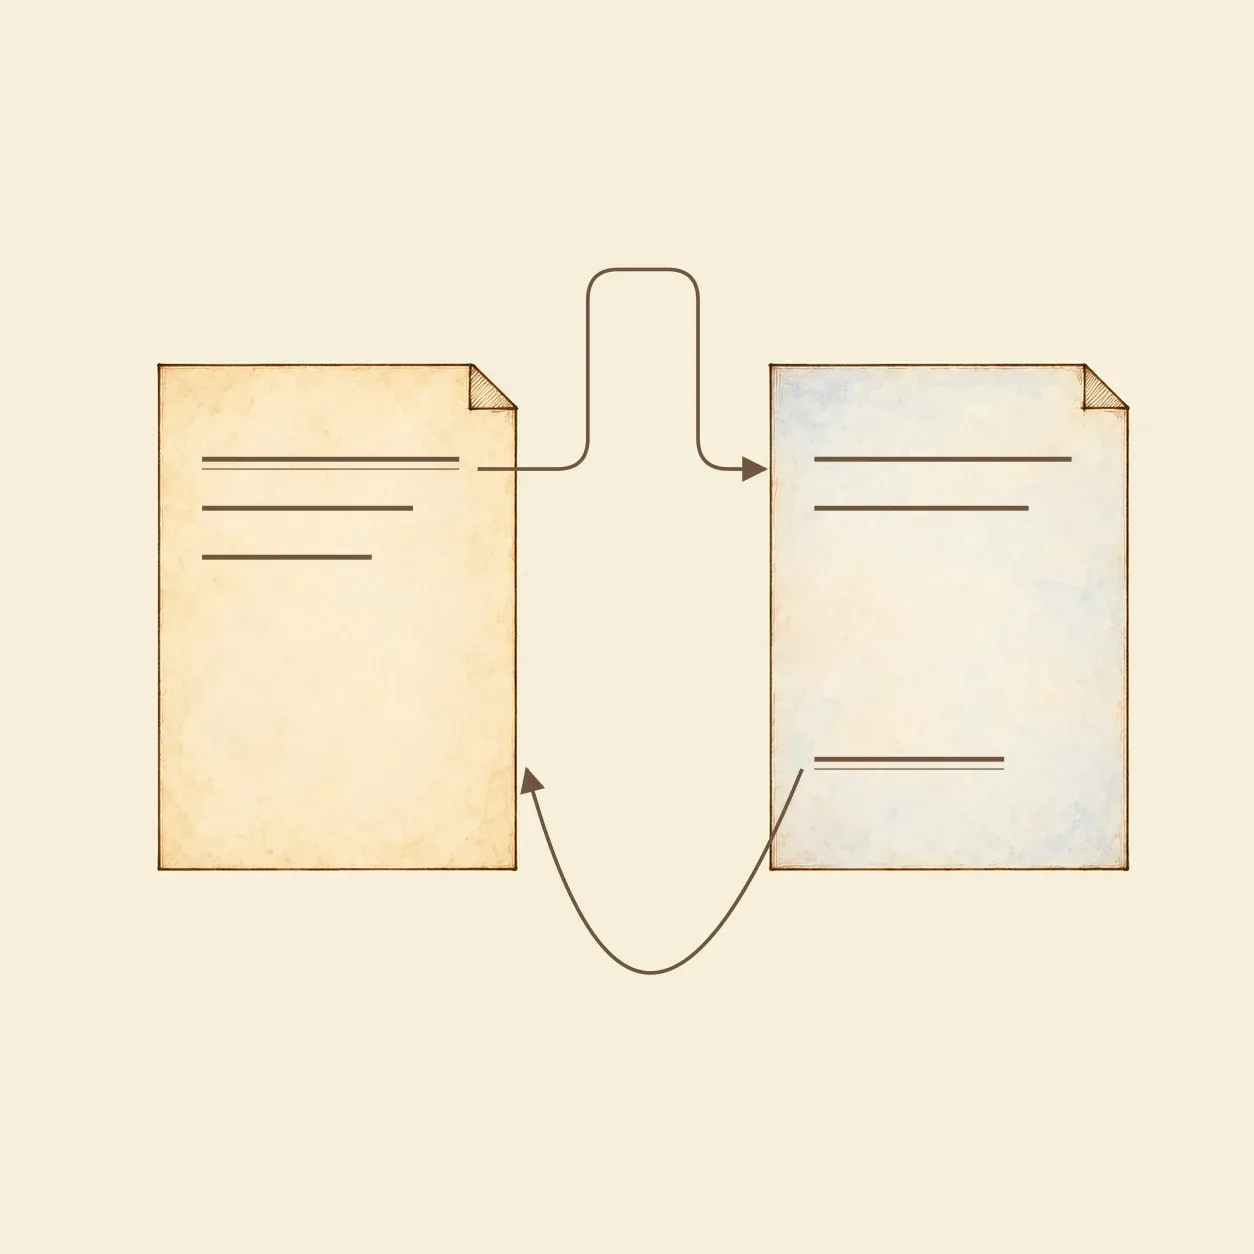 Dos documentos locales permiten probar enlaces de ida y vuelta.
Utilice un ordenador con navegador y un editor de texto sencillo. Cree una carpeta con los archivos a.html y b.html. Guárdelos como texto sin formato y conserve la extensión .html. El primero debe contener:
<!doctype html>
<meta charset="utf-8">
<title>A</title>
<p>A <a href="b.html">B</a></p>
En el segundo, cambie A por B, el destino por a.html y el texto del enlace por A. Abra a.html en el navegador, siga B y vuelva por A. Después cambie el destino a absent.html: el navegador ya no encuentra el archivo. Restituya el nombre original y vuelva a cargar la página.
Aquí se leen archivos locales con una dirección file:. No hay intercambio HTTP. Para estudiar ese intercambio por separado, dibuje una petición que vaya del cliente al servidor y una respuesta de vuelta que contenga el documento HTML. Distinga el enlace escrito, la petición que desencadena y los datos que se reciben.
Historia y evolución
Los textos enlazados preceden a la Web. Vannevar Bush presentó el proyecto Memex en 1945; Doug Engelbart y Ted Nelson desarrollaron después ideas y sistemas de hipertexto. En 1980, Berners-Lee escribió ENQUIRE en el CERN para relacionar información. Estos antecedentes ayudan a entender su proyecto de documentos distribuidos.
En marzo de 1989 propuso un sistema de información enlazada para el CERN. Robert Cailliau colaboró en una nueva propuesta en 1990. Berners-Lee programó en un NeXT el navegador y editor WorldWideWeb, además de un servidor. Los programas podían demostrarse a finales de aquel año. Nicola Pellow desarrolló un navegador en modo texto para más tipos de ordenadores; en agosto de 1991 se anunciaron el proyecto y sus archivos en grupos públicos de Internet.
Mosaic facilitó el acceso gráfico en 1993. El 30 de abril de ese año, el CERN hizo que su software web pudiera utilizarse libremente. El W3C se fundó en 1994 para desarrollar especificaciones comunes. Los formatos y los protocolos siguieron evolucionando, mientras los documentos con dirección propia y sus enlaces se mantuvieron en el centro del sistema.