World Wide Web
Documentos ligados por endereços e hiperligações
Índice
- 1Navegador cliente
- 2Endereço do recurso
- 3Pedido HTTP
- 4Servidor e documento HTML
- 5Resposta ao navegador
A World Wide Web liga documentos através de hiperligações que se seguem num navegador. Tim Berners-Lee propôs o sistema no CERN em 1989, reunindo endereços, um protocolo de troca e uma linguagem de documentos. Os programas operacionais de 1990 permitiram consultar informação em computadores diferentes.
O que é
A Web é um sistema de documentos e outros recursos ligados por endereços. Uma hiperligação leva de uma página a outra, que pode estar guardada num computador diferente. O navegador apresenta o documento e permite escolher as ligações. Um servidor fornece os recursos pedidos. Assim, é possível consultar informação dispersa sem aprender os comandos próprios de cada máquina.
A Internet assegura a comunicação entre redes. A Web acrescenta regras comuns para endereçar, pedir e apresentar informação. O correio eletrónico também utiliza a Internet, com outros protocolos. Uma página pode conter texto, imagens e hiperligações. Um motor de pesquisa ajuda a encontrar páginas, mas quem conhece um endereço pode abri-lo diretamente.
Como funciona
 Uma hiperligação associa uma passagem visível ao endereço de outro recurso.
Um URL indica como chegar a um recurso. Num endereço HTTP simples aparecem o protocolo, o nome do anfitrião e um caminho. O servidor determina o significado desse caminho, que não tem de corresponder a um ficheiro físico. Uma ligação pode conter um endereço completo ou uma referência relativa, resolvida a partir do endereço do documento onde se encontra.
O HTTP organiza a troca entre cliente e servidor. O navegador envia um pedido; o método GET pede uma representação do recurso indicado. O servidor devolve um estado, informação sobre o conteúdo e, quando aplicável, o próprio conteúdo. No HTTP/1.0, descrito em 1996, o código 200 indica sucesso e 404 indica que o recurso não foi encontrado. Estes códigos descrevem a troca, sem garantir a qualidade da informação recebida.
O HTML estrutura o documento com etiquetas. Títulos e parágrafos têm elementos próprios. O elemento a contém uma hiperligação e o atributo href indica o destino. O navegador interpreta esta estrutura para a apresentar. As palavras selecionáveis podem diferir do endereço associado. O documento transferido e a página visível no ecrã são, por isso, aspetos distintos da consulta.
Como fazer
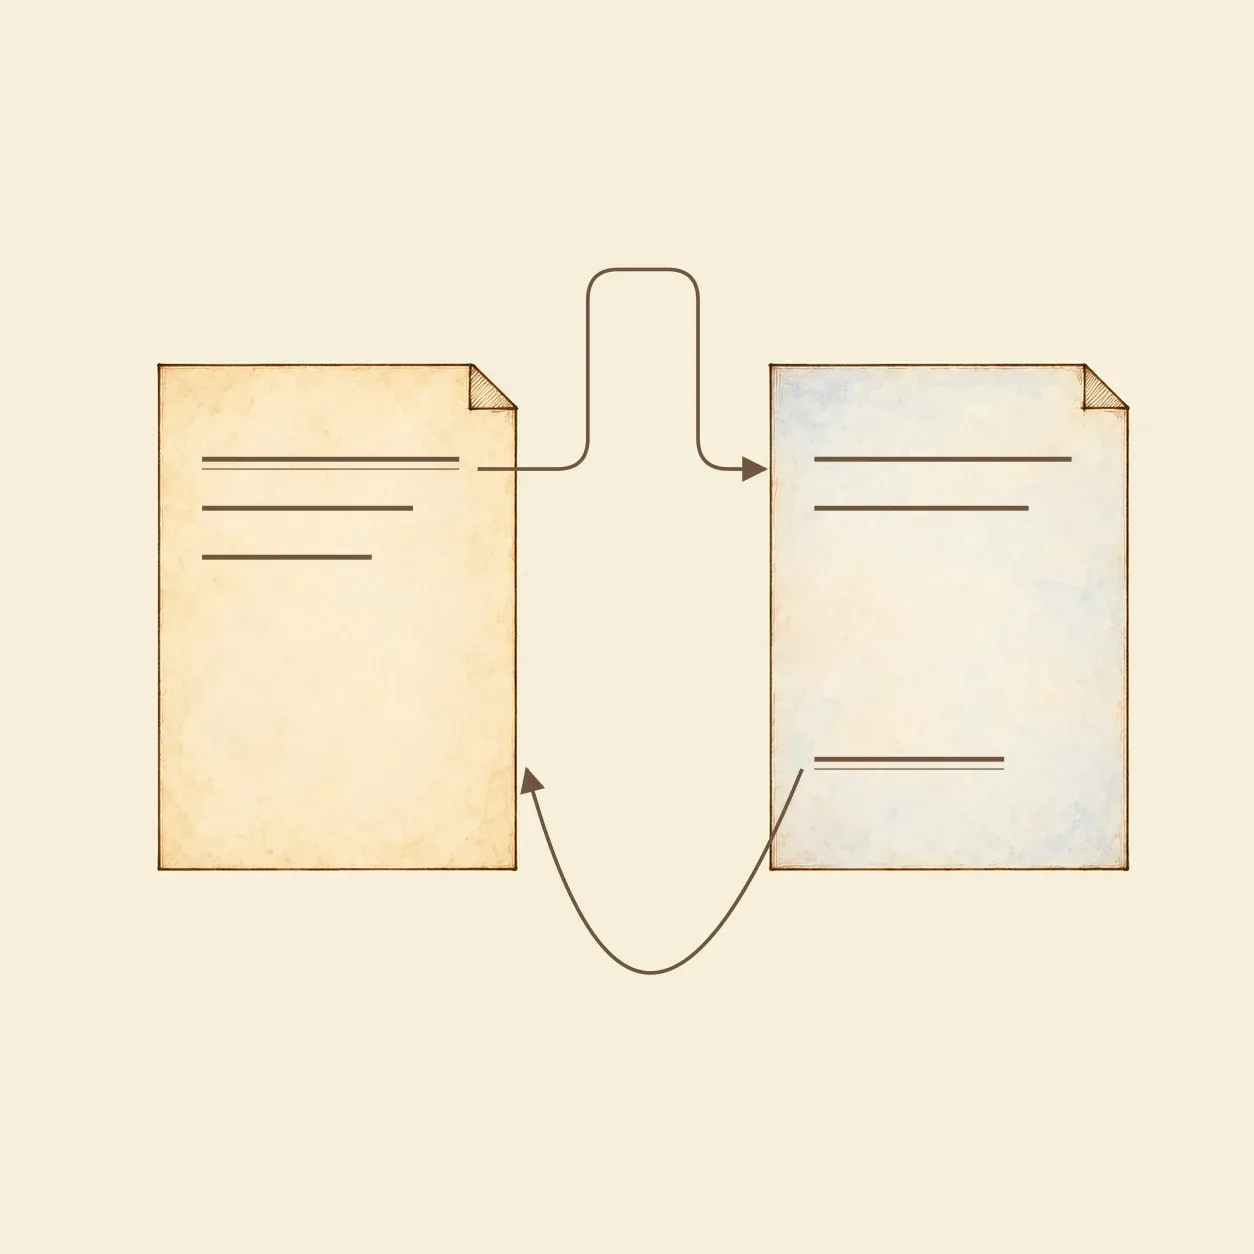 Dois documentos locais permitem experimentar ligações nos dois sentidos.
Utilize um computador com navegador e um editor de texto simples. Crie uma pasta com os ficheiros a.html e b.html. Guarde-os como texto simples e mantenha a extensão .html. O primeiro contém:
<!doctype html>
<meta charset="utf-8">
<title>A</title>
<p>A <a href="b.html">B</a></p>
No segundo, troque A por B, o destino por a.html e o texto da ligação por A. Abra a.html no navegador, siga B e regresse por A. Depois altere o destino para absent.html: o navegador deixa de encontrar o ficheiro. Reponha o nome e volte a carregar a página.
O navegador lê aqui ficheiros locais através de um endereço file:. Não há troca HTTP. Para estudar essa troca separadamente, desenhe um pedido do cliente para o servidor e uma resposta no sentido inverso, com o documento HTML dentro dela. Distinga a ligação escrita no documento, o pedido que desencadeia e os dados recebidos.
História e evolução
Os textos ligados precedem a Web. Vannevar Bush apresentou o projeto Memex em 1945; Doug Engelbart e Ted Nelson desenvolveram depois ideias e sistemas de hipertexto. Berners-Lee criou o ENQUIRE no CERN em 1980 para relacionar informações. Estes antecedentes ajudam a compreender o seu projeto de documentos distribuídos.
Em março de 1989, propôs ao CERN um sistema de informação baseado em ligações. Robert Cailliau colaborou numa nova proposta em 1990. Berners-Lee programou num NeXT o navegador e editor WorldWideWeb, bem como um servidor. Os programas podiam ser demonstrados no final desse ano. Nicola Pellow desenvolveu um navegador de texto para mais tipos de máquinas; em agosto de 1991, o projeto e os seus ficheiros foram anunciados em grupos públicos da Internet.
O Mosaic facilitou a navegação gráfica em 1993. A 30 de abril desse ano, o CERN tornou o seu software web livremente utilizável. O W3C foi fundado em 1994 para desenvolver especificações comuns. Os formatos e protocolos continuaram a evoluir, mantendo os documentos endereçáveis e as suas ligações no centro do sistema.