Architecture Transformer
Pondérer les relations d’une séquence
Sommaire
- 1Représentations et positions en entrée
- 2Encodeur à auto-attention
- 3Sorties précédentes et positions
- 4Décodeur à auto-attention masquée
- 5Attention vers les sorties de l’encodeur
- 6Projection et probabilités de sortie
Le Transformer est une architecture de réseau neuronal publiée en 2017 par Ashish Vaswani et ses coauteurs. Pour traiter des séquences, elle combine attention, transformations numériques et information de position ; le modèle d'origine comporte un encodeur et un décodeur, étudiés notamment pour la traduction automatique.
Ce que c’est
Un Transformer transforme une suite de représentations numériques en une autre suite. Pour du texte, les unités traitées, ou tokens, reçoivent des vecteurs : des listes de nombres que le réseau modifie. Dans l’architecture de traduction publiée en 2017, l’encodeur traite l’entrée et le décodeur construit la sortie à partir des éléments déjà disponibles.
Le réseau apprend des paramètres sur des exemples d’entraînement. Une fois ces paramètres fixés, une entrée détermine un calcul ; la production d’un texte dépend aussi de la façon de choisir les sorties. Les réseaux neuronaux, la traduction automatique et les mécanismes d’attention possèdent déjà une histoire lorsque paraît cet assemblage. Son apport porte sur une architecture précise de traitement des séquences.
Comment ça marche
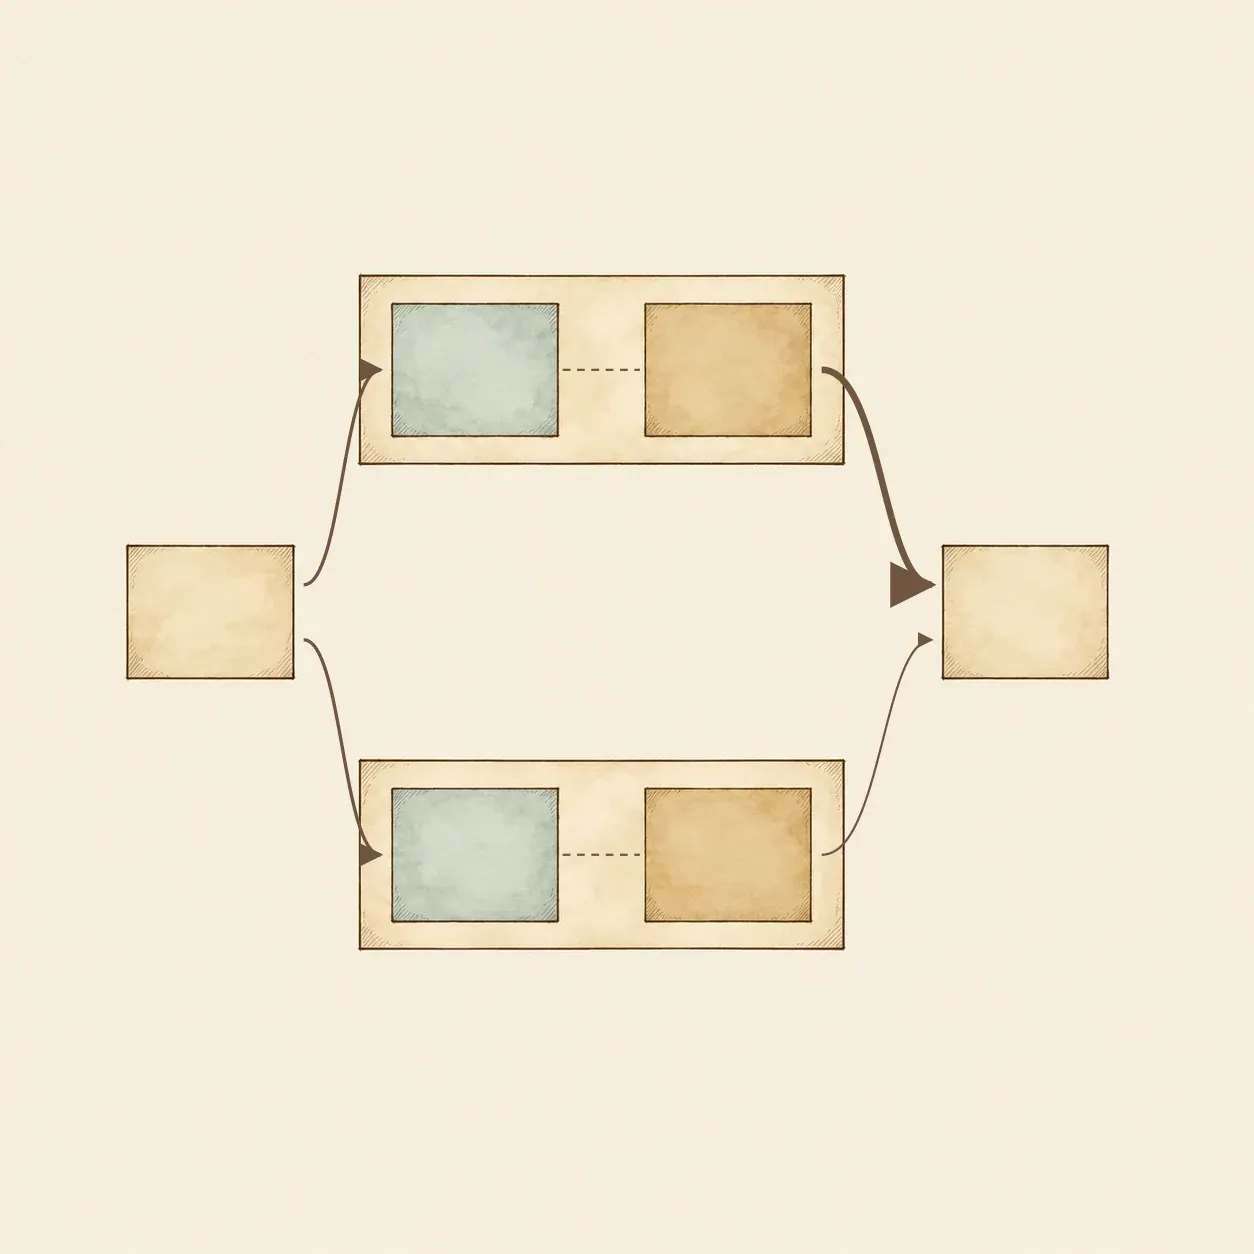 Dans chaque paire, la clé est à gauche, la valeur à droite. Les valeurs pondérées se combinent en sortie.
L’attention forme une requête, des clés et des valeurs à partir de représentations. Le produit scalaire de la requête avec chaque clé donne un score, divisé par la racine carrée de la dimension des clés. Le softmax exponentie ces scores et les divise par leur somme. Les poids obtenus servent à additionner les valeurs pondérées. Une requête rassemble ainsi de l’information provenant de plusieurs positions.
Dans l’auto-attention, requêtes, clés et valeurs proviennent de la même séquence, avec des projections apprises distinctes. Plusieurs têtes travaillent sur des projections différentes ; leurs sorties sont réunies et transformées. L’encodeur peut mettre les positions d’entrée en relation. Le décodeur masque les positions futures de sa sortie et consulte aussi les représentations de l’encodeur par une attention séparée.
L’attention est accompagnée de réseaux appliqués à chaque position, de connexions résiduelles qui ajoutent l’entrée d’une sous-couche à son résultat et de normalisations. Une information de position complète les vecteurs, car les seules comparaisons de contenu ne fournissent pas l’ordre de la séquence. Le modèle de base décrit six couches d’encodeur, six de décodeur et huit têtes dans ses sous-couches d’attention multi-têtes.
Dans l’attention entre encodeur et décodeur, les requêtes viennent du décodeur, tandis que clés et valeurs viennent de la sortie de l’encodeur. Dans le modèle original, la normalisation suit chaque addition résiduelle. Ces opérations sont répétées à chaque couche ; les poids appris peuvent différer d’une couche à l’autre.
Pendant l’entraînement, les éléments connus de la sortie attendue sont décalés avant d’entrer dans le décodeur. Le masque empêche alors chaque position d’utiliser les éléments futurs, même si plusieurs positions sont calculées ensemble. Lors de la génération, le décodeur reçoit les éléments déjà produits et calcule les probabilités de l’élément suivant.
Comment faire
Un ordinateur et une calculatrice suffisent pour essayer une opération d’attention. Choisissez une dimension de clé égale à 1, une requête égale à 1, deux clés ln(3) et 0, puis deux valeurs 2 et 6. ln désigne le logarithme naturel. Ces nombres sont choisis pour le calcul, sans apprentissage préalable.
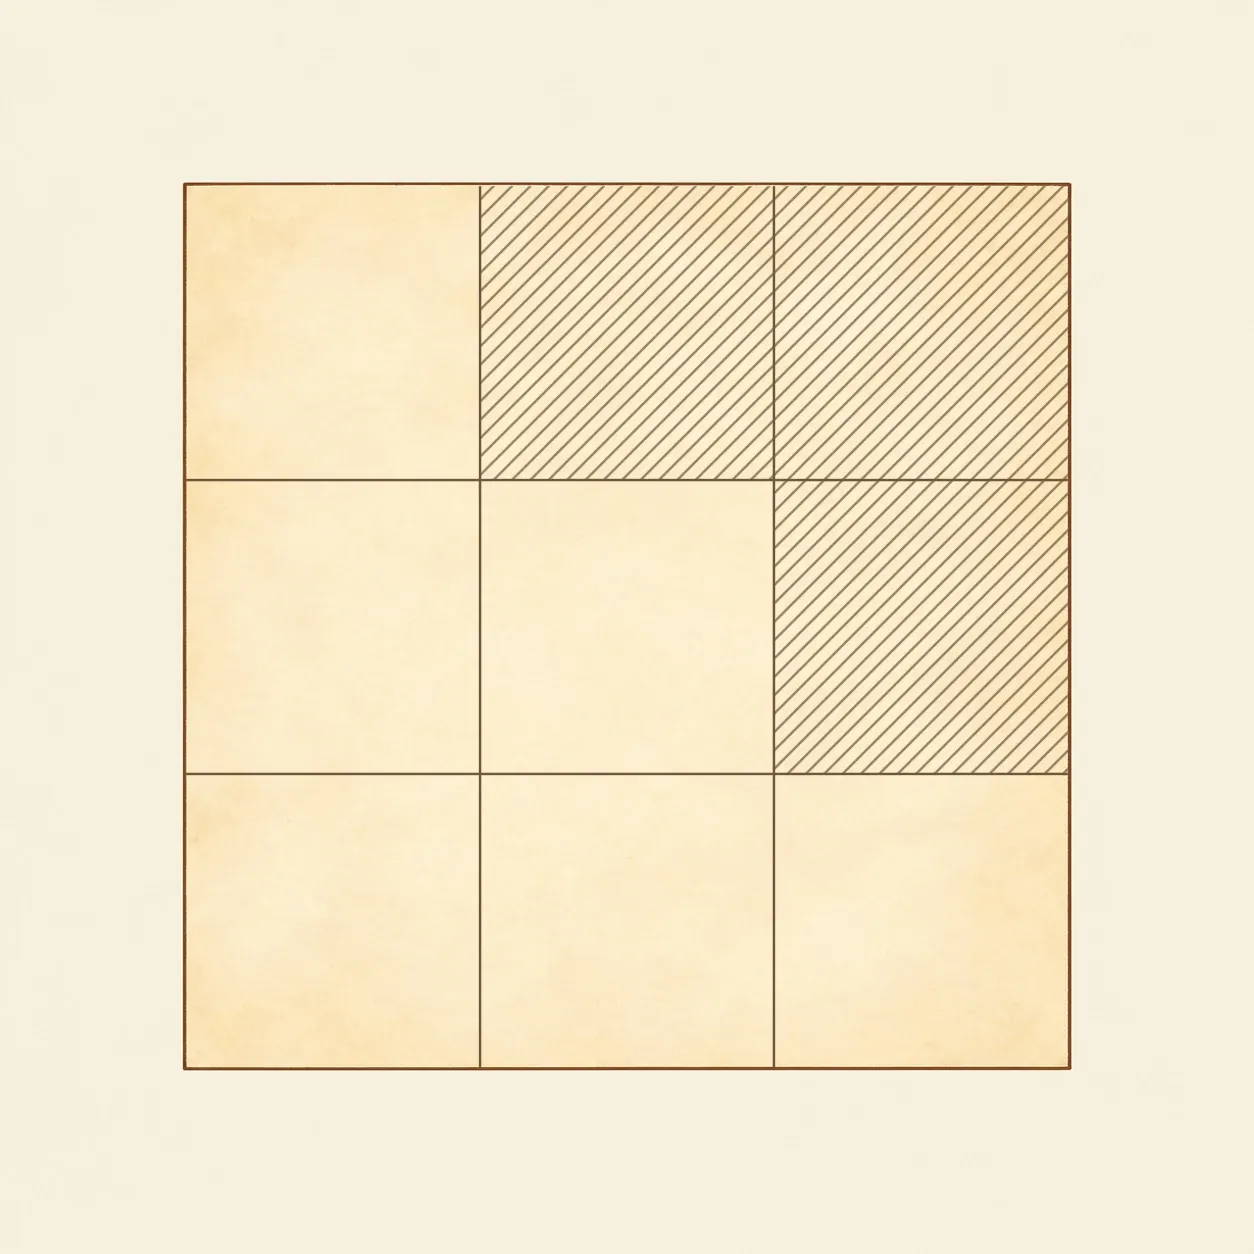 Un masque causal interdit les positions futures au-dessus de la diagonale : les lignes sont les requêtes, les colonnes les clés.
Les scores valent ln(3) et 0, car la racine carrée de 1 vaut 1. Leurs exponentielles valent 3 et 1. Leur somme vaut 4 : les poids sont donc 3/4 et 1/4. La valeur de sortie vaut (3/4 × 2) + (1/4 × 6) = 3. Le poids le plus grand ne supprime pas automatiquement l’autre contribution.
Reprenez le calcul en interdisant la seconde clé. Donnez à son score la valeur moins l’infini avant le softmax : son exponentielle vaut alors 0. Les poids deviennent 1 et 0 et la sortie vaut 2. Dans une séquence, ce principe interdit à une position de consulter les éléments suivants. Un masque triangulaire laisse accessibles la position courante et les précédentes.
Pour entraîner un réseau complet, il faut définir les représentations, toutes les couches, les données, l’objectif d’apprentissage et l’ajustement des paramètres.
Histoire et évolution
Bahdanau, Cho et Bengio proposent en 2014 un mécanisme d’alignement appris pour la traduction neuronale, présenté à l’ICLR en 2015. Leur décodeur peut pondérer différentes parties de la phrase source. L’auto-attention est également explorée avant le Transformer, comme le reconnaît l’article de 2017.
Le 12 juin 2017, Vaswani et ses sept coauteurs déposent Attention Is All You Need sur arXiv. Ils construisent un encodeur et un décodeur sans récurrence ni convolution pour relier les positions. Le calcul des représentations se prête davantage au traitement parallèle, tandis que la génération autorégressive continue de produire les éléments successivement.
Des développements ultérieurs emploient des encodeurs, des décodeurs ou leur combinaison pour d’autres tâches. Ces variantes changent les usages et l’entraînement ; l’architecture publiée en 2017 reste le point de départ de la famille Transformer.