Architettura Transformer
Pesare relazioni tra posizioni di una sequenza
Indice
- 1Rappresentazioni e posizioni in ingresso
- 2Codificatore con autoattenzione
- 3Uscite precedenti e posizioni
- 4Decodificatore con autoattenzione mascherata
- 5Attenzione alle uscite del codificatore
- 6Proiezione e probabilità di uscita
Il Transformer è un'architettura di rete neurale pubblicata nel 2017 da Ashish Vaswani e dai suoi coautori. Elabora sequenze mediante attenzione, trasformazioni numeriche e informazioni di posizione; il modello originale comprende un codificatore e un decodificatore, studiati soprattutto per la traduzione automatica.
Che cos’è
Un Transformer trasforma una sequenza di rappresentazioni numeriche in un’altra sequenza. Nel testo, le unità elaborate, chiamate token, ricevono vettori: liste di numeri che la rete modifica. Nell’architettura per la traduzione pubblicata nel 2017, il codificatore elabora l’ingresso e il decodificatore costruisce l’uscita a partire dagli elementi già disponibili.
La rete apprende parametri da esempi di addestramento. Una volta fissati i parametri, un ingresso determina un calcolo; la generazione del testo dipende anche dal modo in cui si scelgono le uscite. Reti neurali, traduzione automatica e meccanismi di attenzione avevano già una storia quando apparve questa combinazione. Il suo contributo riguarda un’architettura precisa per elaborare sequenze.
Come funziona
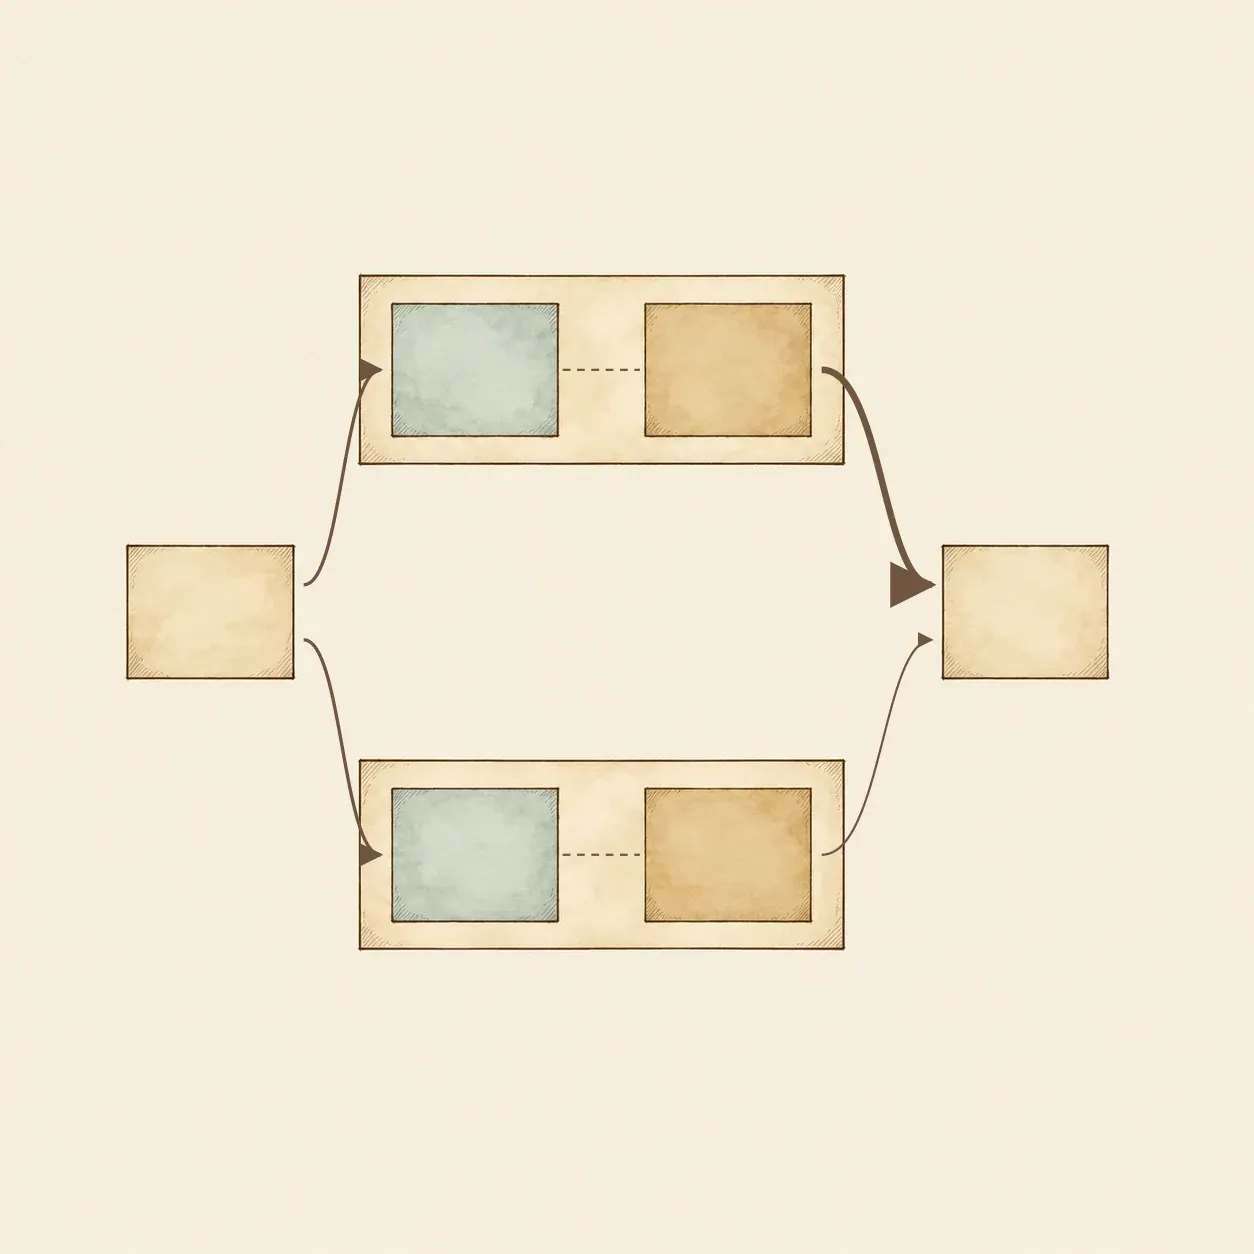 In ogni coppia la chiave è a sinistra e il valore a destra. I valori pesati si combinano nell’uscita.
L’attenzione ricava query, chiavi e valori dalle rappresentazioni. Il prodotto scalare della query con ciascuna chiave dà un punteggio, diviso per la radice quadrata della dimensione delle chiavi. Il softmax calcola gli esponenziali e li divide per la loro somma. I pesi risultanti permettono di sommare i valori ponderati. Una query può quindi raccogliere informazioni da diverse posizioni.
Nell’autoattenzione, query, chiavi e valori provengono dalla stessa sequenza, attraverso proiezioni apprese distinte. Più teste lavorano su proiezioni differenti; le loro uscite vengono concatenate e trasformate. Il codificatore mette in relazione le posizioni d’ingresso. Il decodificatore maschera le posizioni future dell’uscita e consulta anche le rappresentazioni del codificatore attraverso un’attenzione separata.
L’architettura comprende reti applicate a ogni posizione, connessioni residue che sommano l’ingresso di un sottostrato al suo risultato e normalizzazioni. L’informazione di posizione completa i vettori, perché il solo confronto dei contenuti non stabilisce l’ordine. Il modello base descrive sei strati del codificatore, sei del decodificatore e otto teste nei sottostrati di attenzione a più teste.
Nell’attenzione fra codificatore e decodificatore, le query provengono dal decodificatore, mentre chiavi e valori vengono dall’uscita del codificatore. Nel modello originale la normalizzazione segue ogni somma residua. Le operazioni si ripetono a ogni strato, con pesi appresi che possono cambiare da uno strato all’altro.
Durante l’addestramento, gli elementi noti dell’uscita attesa vengono spostati prima di entrare nel decodificatore. La maschera impedisce a ogni posizione di usare gli elementi futuri, anche quando più posizioni vengono calcolate insieme. Durante la generazione, il decodificatore riceve gli elementi già prodotti e calcola le probabilità dell’elemento successivo.
Come si fa
Un computer e una calcolatrice bastano per provare un’operazione di attenzione. Scegliete una dimensione della chiave pari a 1, una query pari a 1, due chiavi ln(3) e 0 e due valori 2 e 6. Qui ln indica il logaritmo naturale. I numeri sono scelti per il calcolo, senza alcun addestramento.
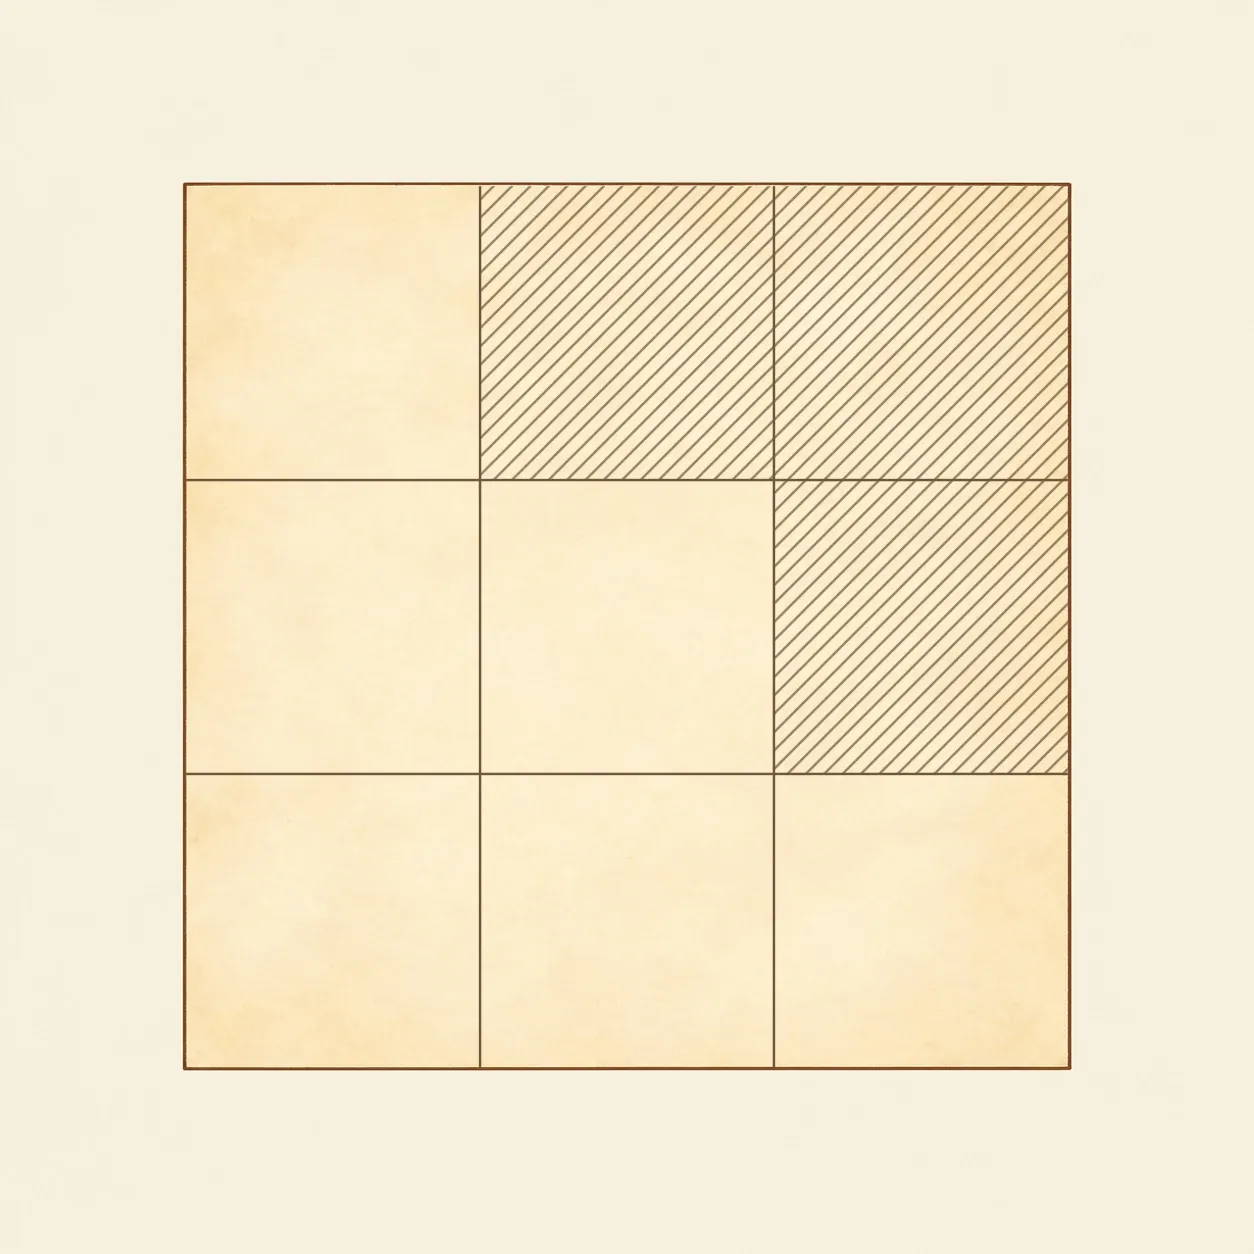 Una maschera causale blocca le posizioni future sopra la diagonale: le righe sono query e le colonne sono chiavi.
I punteggi sono ln(3) e 0, poiché la radice quadrata di 1 vale 1. I loro esponenziali valgono 3 e 1, la cui somma è 4. I pesi sono quindi 3/4 e 1/4. L’uscita vale (3/4 × 2) + (1/4 × 6) = 3. Il peso maggiore non elimina automaticamente l’altro contributo.
Ripetete il calcolo escludendo la seconda chiave. Assegnate al suo punteggio meno infinito prima del softmax: il suo esponenziale diventa 0. I pesi diventano 1 e 0 e l’uscita vale 2. In una sequenza, questa regola impedisce a una posizione di consultare elementi successivi. Una maschera triangolare lascia accessibili la posizione corrente e quelle precedenti.
Per addestrare una rete completa occorre definire le rappresentazioni, tutti gli strati, i dati, l’obiettivo di apprendimento e gli aggiornamenti dei parametri.
Storia ed evoluzione
Bahdanau, Cho e Bengio proposero nel 2014 un meccanismo di allineamento appreso per la traduzione neurale, presentato all’ICLR nel 2015. Il loro decodificatore poteva pesare parti differenti della frase di partenza. Anche l’autoattenzione era stata studiata prima del Transformer, come riconosce l’articolo del 2017.
Il 12 giugno 2017 Vaswani e sette coautori depositarono Attention Is All You Need su arXiv. Costruirono un codificatore e un decodificatore senza ricorrenza né convoluzione per collegare le posizioni. Il calcolo delle rappresentazioni consentiva maggiore parallelismo, mentre la generazione autoregressiva continuava a produrre elementi in successione.
Sviluppi successivi impiegano codificatori, decodificatori o entrambi per altri compiti. Queste varianti cambiano impieghi e addestramento. L’architettura pubblicata nel 2017 rimane il punto di partenza della famiglia Transformer.