Arquitectura Transformer
Ponderar relaciones entre posiciones de una secuencia
Contenido
- 1Representaciones y posiciones de entrada
- 2Codificador con autoatención
- 3Salidas anteriores y posiciones
- 4Decodificador con autoatención enmascarada
- 5Atención a las salidas del codificador
- 6Proyección y probabilidades de salida
El Transformer es una arquitectura de red neuronal publicada en 2017 por Ashish Vaswani y sus coautores. Procesa secuencias mediante atención, transformaciones numéricas e información de posición; el modelo original incluye un codificador y un decodificador, estudiados especialmente para la traducción automática.
Qué es
Un Transformer convierte una secuencia de representaciones numéricas en otra secuencia. Para el texto, las unidades procesadas, o tokens, reciben vectores: listas de números que la red modifica. En la arquitectura de traducción publicada en 2017, el codificador procesa la entrada y el decodificador construye la salida a partir de los elementos ya disponibles.
La red aprende parámetros con ejemplos de entrenamiento. Una vez fijados, una entrada determina un cálculo; la generación de texto también depende de cómo se eligen las salidas. Las redes neuronales, la traducción automática y los mecanismos de atención ya tenían una historia cuando apareció esta combinación. Su aportación corresponde a una arquitectura concreta de procesamiento de secuencias.
Cómo funciona
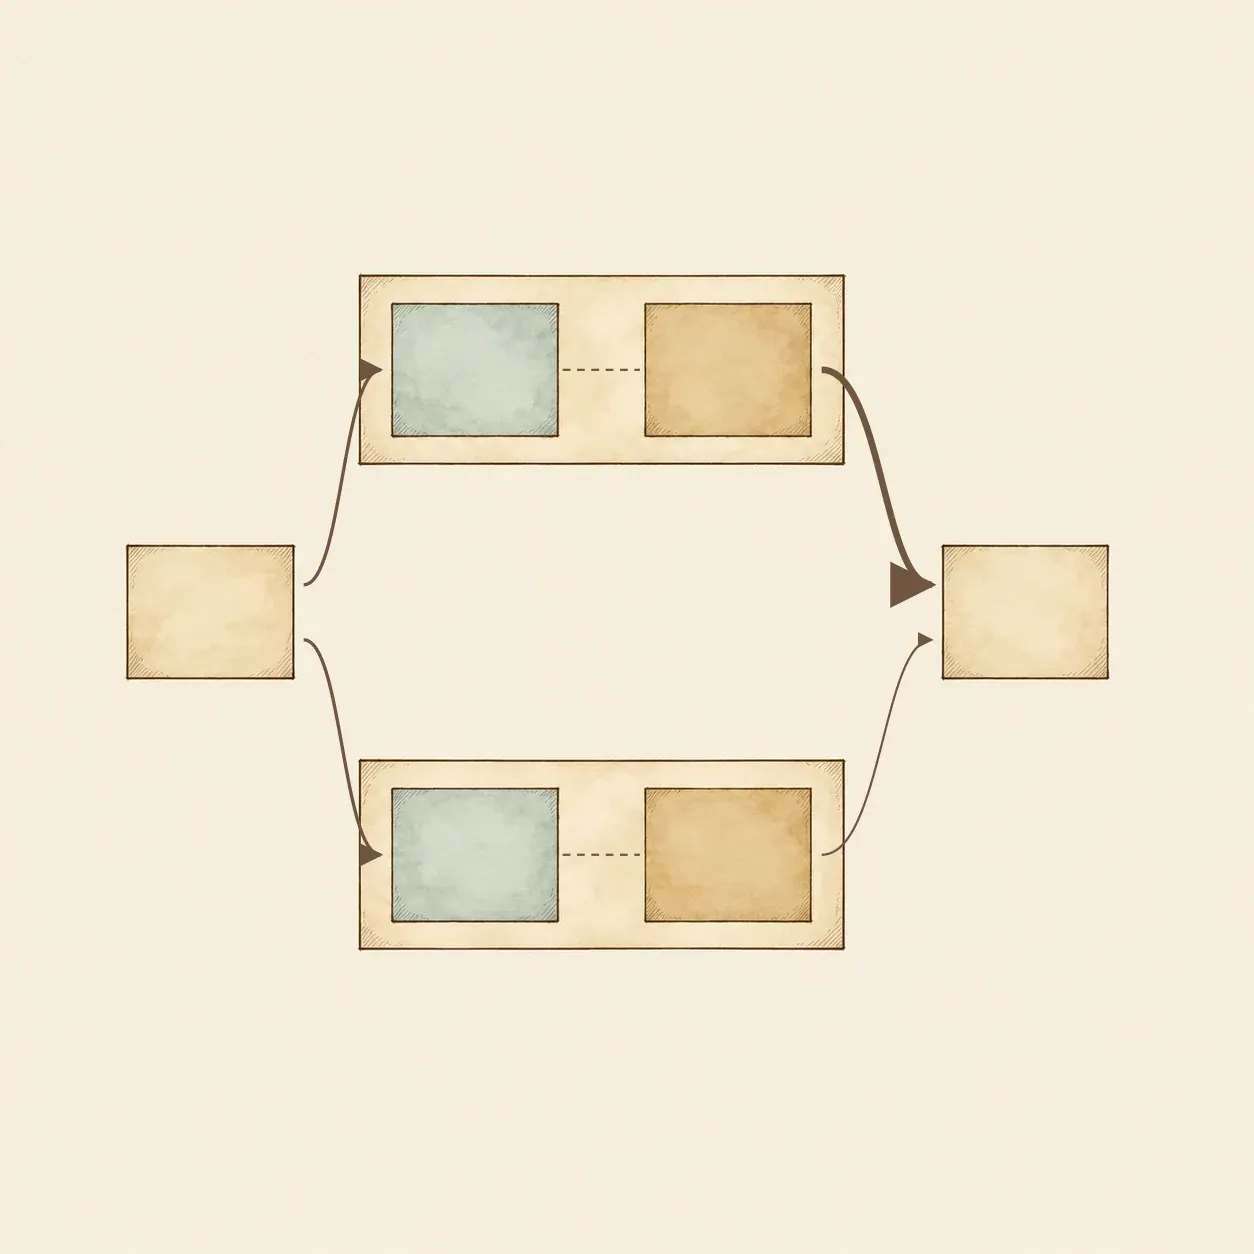 En cada pareja, la clave está a la izquierda y el valor a la derecha. Los valores ponderados se combinan en la salida.
La atención obtiene consultas, claves y valores a partir de representaciones. El producto escalar de la consulta con cada clave da una puntuación, dividida por la raíz cuadrada de la dimensión de las claves. El softmax calcula las exponenciales y las divide por su suma. Los pesos resultantes permiten sumar los valores ponderados. Una consulta reúne así información procedente de varias posiciones.
En la autoatención, consultas, claves y valores proceden de la misma secuencia, mediante proyecciones aprendidas distintas. Varias cabezas trabajan con proyecciones diferentes; sus resultados se concatenan y transforman. El codificador relaciona las posiciones de entrada. El decodificador oculta las posiciones futuras de la salida y consulta además las representaciones del codificador mediante otra operación de atención.
La arquitectura incluye redes aplicadas a cada posición, conexiones residuales que añaden la entrada de una subcapa a su resultado y normalizaciones. La información de posición completa los vectores, ya que las comparaciones de contenido por sí solas no establecen el orden. El modelo base describe seis capas de codificador, seis de decodificador y ocho cabezas en sus subcapas de atención multicabeza.
En la atención entre codificador y decodificador, las consultas proceden del decodificador, mientras que las claves y los valores vienen de la salida del codificador. En el modelo original, la normalización sigue a cada suma residual. Las operaciones se repiten en cada capa, cuyos pesos aprendidos pueden ser diferentes.
Durante el entrenamiento, los elementos conocidos de la salida esperada se desplazan antes de entrar en el decodificador. La máscara impide que cada posición use elementos futuros, aunque se calculen varias posiciones a la vez. Durante la generación, el decodificador recibe los elementos ya producidos y calcula las probabilidades del siguiente elemento.
Cómo hacerlo
Un ordenador y una calculadora bastan para probar una operación de atención. Elija una dimensión de clave igual a 1, una consulta igual a 1, dos claves ln(3) y 0, y dos valores 2 y 6. Aquí ln indica el logaritmo natural. Los números se eligen para el cálculo, sin entrenamiento previo.
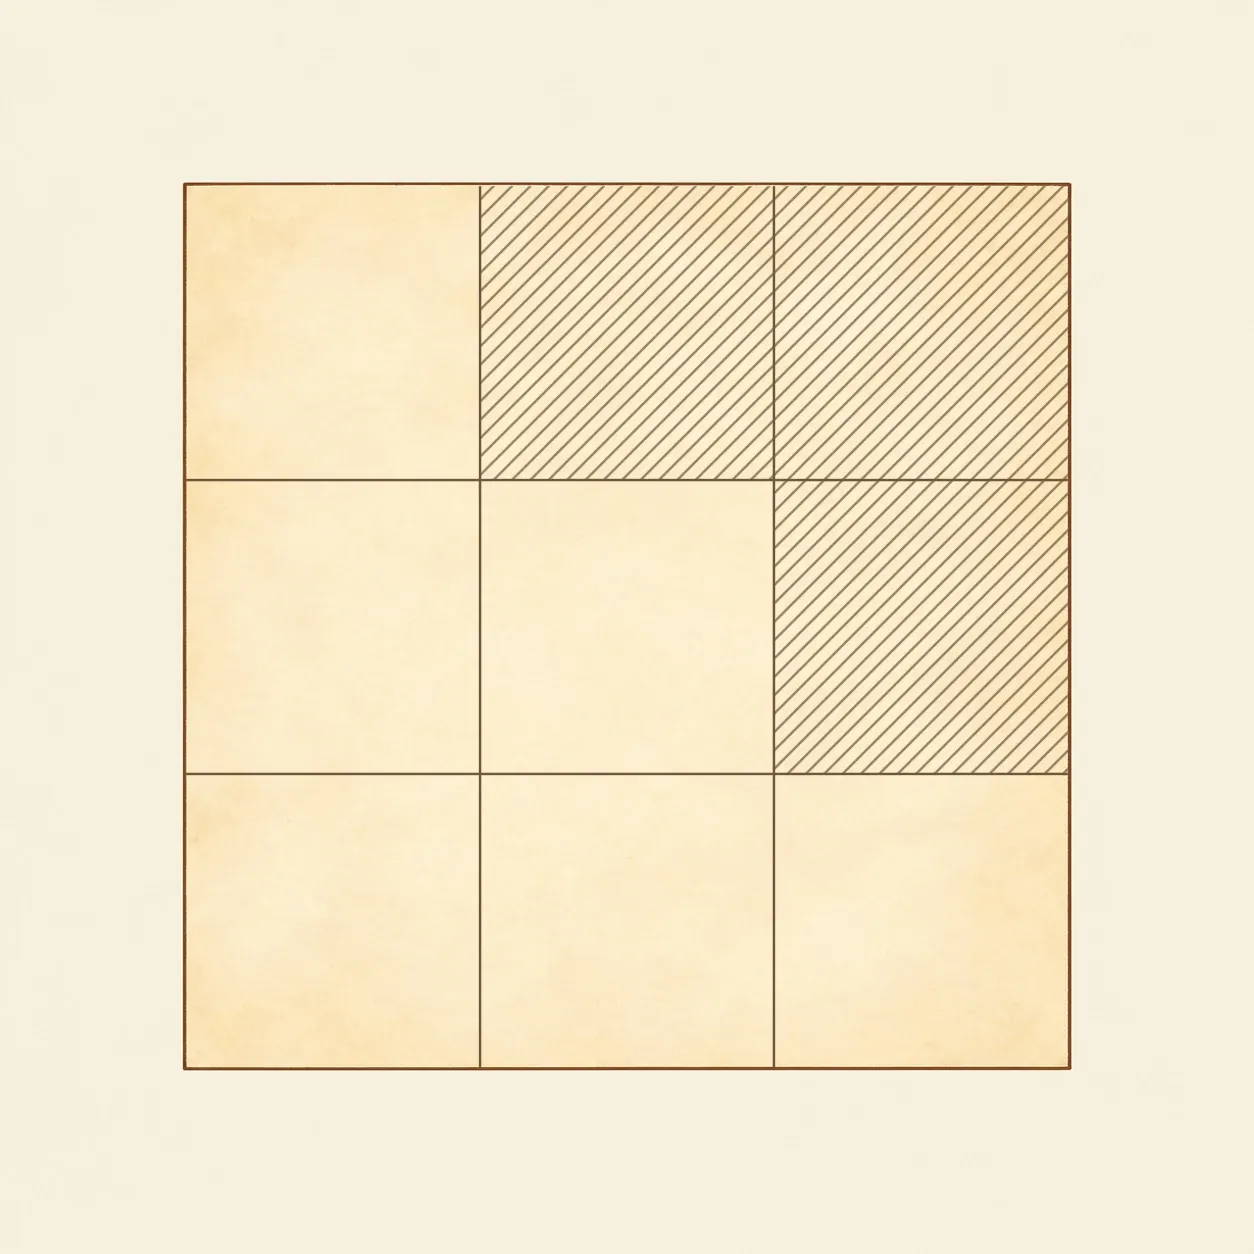 Una máscara causal bloquea las posiciones futuras sobre la diagonal: las filas son consultas y las columnas son claves.
Las puntuaciones son ln(3) y 0, pues la raíz cuadrada de 1 es 1. Sus exponenciales valen 3 y 1, cuya suma es 4. Los pesos son, por tanto, 3/4 y 1/4. La salida vale (3/4 × 2) + (1/4 × 6) = 3. El mayor peso no elimina automáticamente la otra contribución.
Repita el cálculo prohibiendo la segunda clave. Asigne a su puntuación menos infinito antes del softmax: su exponencial pasa a valer 0. Los pesos se convierten en 1 y 0 y la salida vale 2. En una secuencia, esta regla impide consultar elementos posteriores. Una máscara triangular mantiene accesibles la posición actual y las anteriores.
Entrenar una red completa exige definir las representaciones, todas las capas, los datos, el objetivo de aprendizaje y los ajustes de parámetros.
Historia y evolución
Bahdanau, Cho y Bengio propusieron en 2014 un mecanismo de alineamiento aprendido para traducción neuronal, presentado en ICLR en 2015. Su decodificador podía ponderar partes distintas de la frase de origen. La autoatención también se investigaba antes del Transformer, como reconoce el artículo de 2017.
El 12 de junio de 2017, Vaswani y siete coautores depositaron Attention Is All You Need en arXiv. Construyeron un codificador y un decodificador sin recurrencia ni convolución para relacionar posiciones. El cálculo de representaciones admitía más paralelismo, mientras que la generación autorregresiva seguía produciendo elementos sucesivamente.
Desarrollos posteriores emplean codificadores, decodificadores o ambos para otras tareas. Estas variantes cambian aplicaciones y entrenamiento. La arquitectura publicada en 2017 sigue siendo el punto de partida de la familia Transformer.