Arquitetura Transformer
Ponderar relações entre posições de uma sequência
Índice
- 1Representações e posições de entrada
- 2Codificador com autoatenção
- 3Saídas anteriores e posições
- 4Descodificador com autoatenção mascarada
- 5Atenção às saídas do codificador
- 6Projeção e probabilidades de saída
O Transformer é uma arquitetura de rede neuronal publicada em 2017 por Ashish Vaswani e os seus coautores. Processa sequências através de atenção, transformações numéricas e informação de posição; o modelo original inclui um codificador e um descodificador, estudados sobretudo para a tradução automática.
O que é
Um Transformer transforma uma sequência de representações numéricas noutra sequência. Para o texto, as unidades processadas, ou tokens, recebem vetores: listas de números que a rede modifica. Na arquitetura de tradução publicada em 2017, o codificador processa a entrada e o descodificador constrói a saída a partir dos elementos já disponíveis.
A rede aprende parâmetros com exemplos de treino. Depois de fixados os parâmetros, uma entrada determina um cálculo; a produção de texto depende também da forma de escolher as saídas. As redes neuronais, a tradução automática e os mecanismos de atenção já tinham uma história quando surgiu esta combinação. O seu contributo diz respeito a uma arquitetura precisa de processamento de sequências.
Como funciona
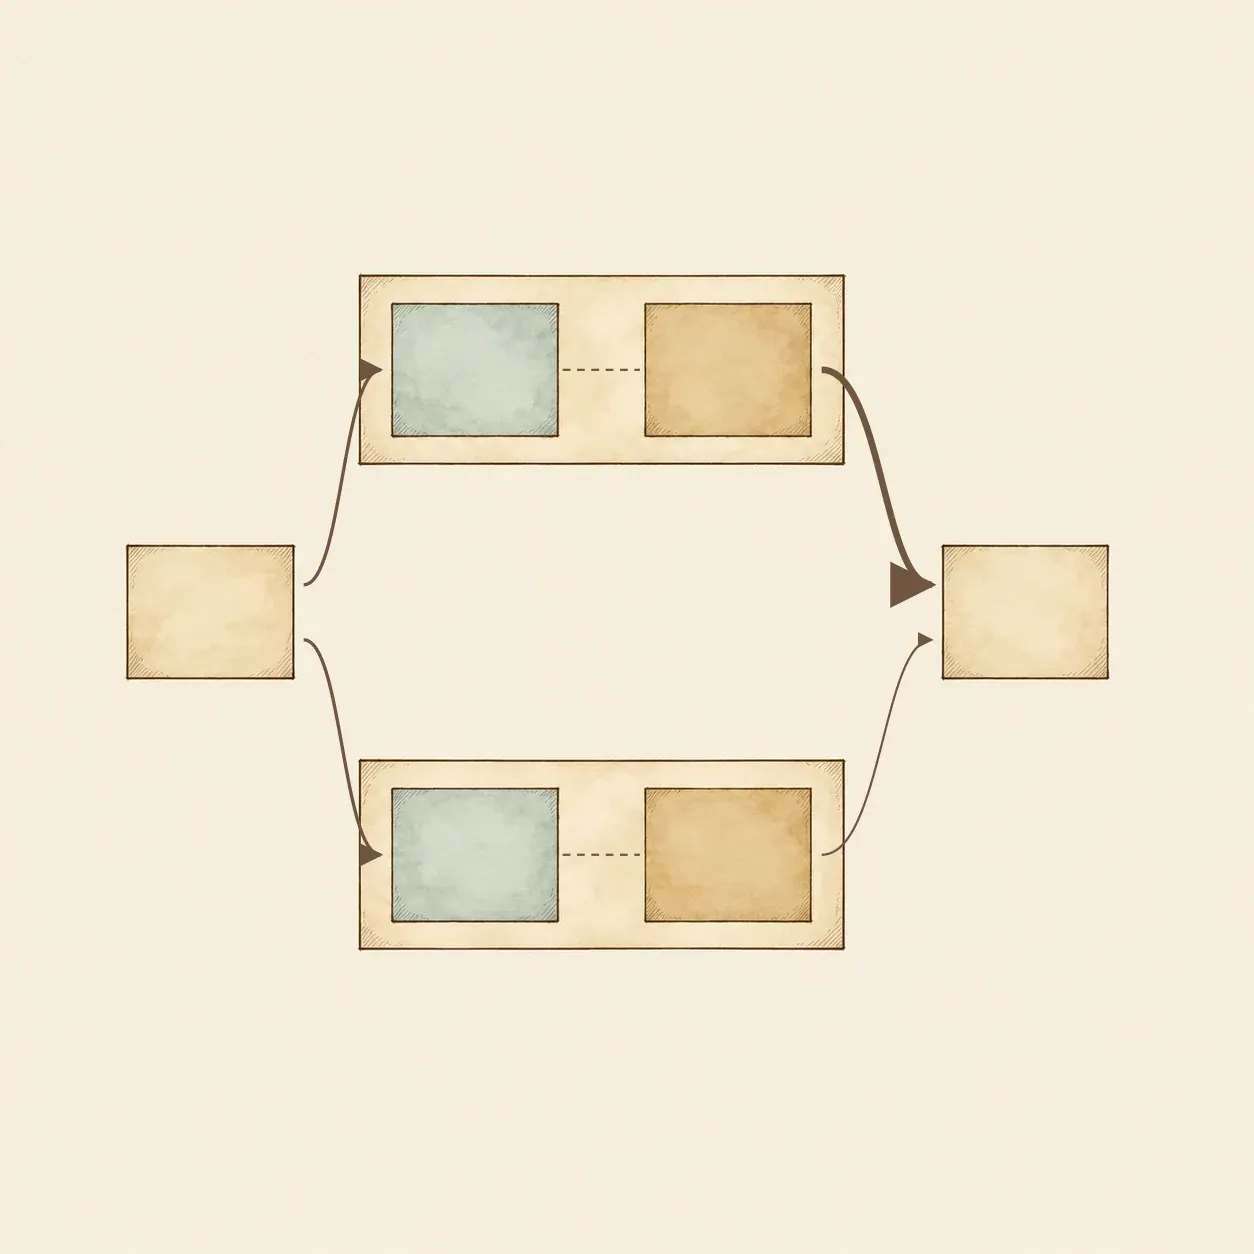 Em cada par, a chave fica à esquerda e o valor à direita. Os valores ponderados combinam-se na saída.
A atenção forma consultas, chaves e valores a partir das representações. O produto escalar da consulta com cada chave dá uma pontuação, dividida pela raiz quadrada da dimensão das chaves. O softmax calcula as exponenciais e divide-as pela sua soma. Os pesos obtidos permitem somar os valores ponderados. Uma consulta pode assim reunir informação proveniente de várias posições.
Na autoatenção, consultas, chaves e valores provêm da mesma sequência, através de projeções aprendidas distintas. Várias cabeças trabalham com projeções diferentes; as suas saídas são concatenadas e transformadas. O codificador relaciona as posições de entrada. O descodificador mascara as posições futuras da saída e consulta também as representações do codificador através de uma atenção separada.
A arquitetura inclui redes aplicadas a cada posição, ligações residuais que adicionam a entrada de uma subcamada ao seu resultado e normalizações. A informação de posição completa os vetores, porque as comparações de conteúdo, por si só, não fornecem a ordem da sequência. O modelo base descreve seis camadas de codificador, seis de descodificador e oito cabeças nas suas subcamadas de atenção com várias cabeças.
Na atenção entre codificador e descodificador, as consultas vêm do descodificador, enquanto as chaves e os valores vêm da saída do codificador. No modelo original, a normalização segue cada soma residual. Estas operações repetem-se em cada camada, cujos pesos aprendidos podem ser diferentes.
Durante o treino, os elementos conhecidos da saída esperada são deslocados antes de entrarem no descodificador. A máscara impede cada posição de usar elementos futuros, mesmo quando se calculam várias posições em conjunto. Durante a geração, o descodificador recebe os elementos já produzidos e calcula as probabilidades do elemento seguinte.
Como fazer
Um computador e uma calculadora chegam para experimentar uma operação de atenção. Escolha uma dimensão de chave igual a 1, uma consulta igual a 1, duas chaves ln(3) e 0, e dois valores 2 e 6. Aqui, ln significa logaritmo natural. Os números são escolhidos para o cálculo, sem treino prévio.
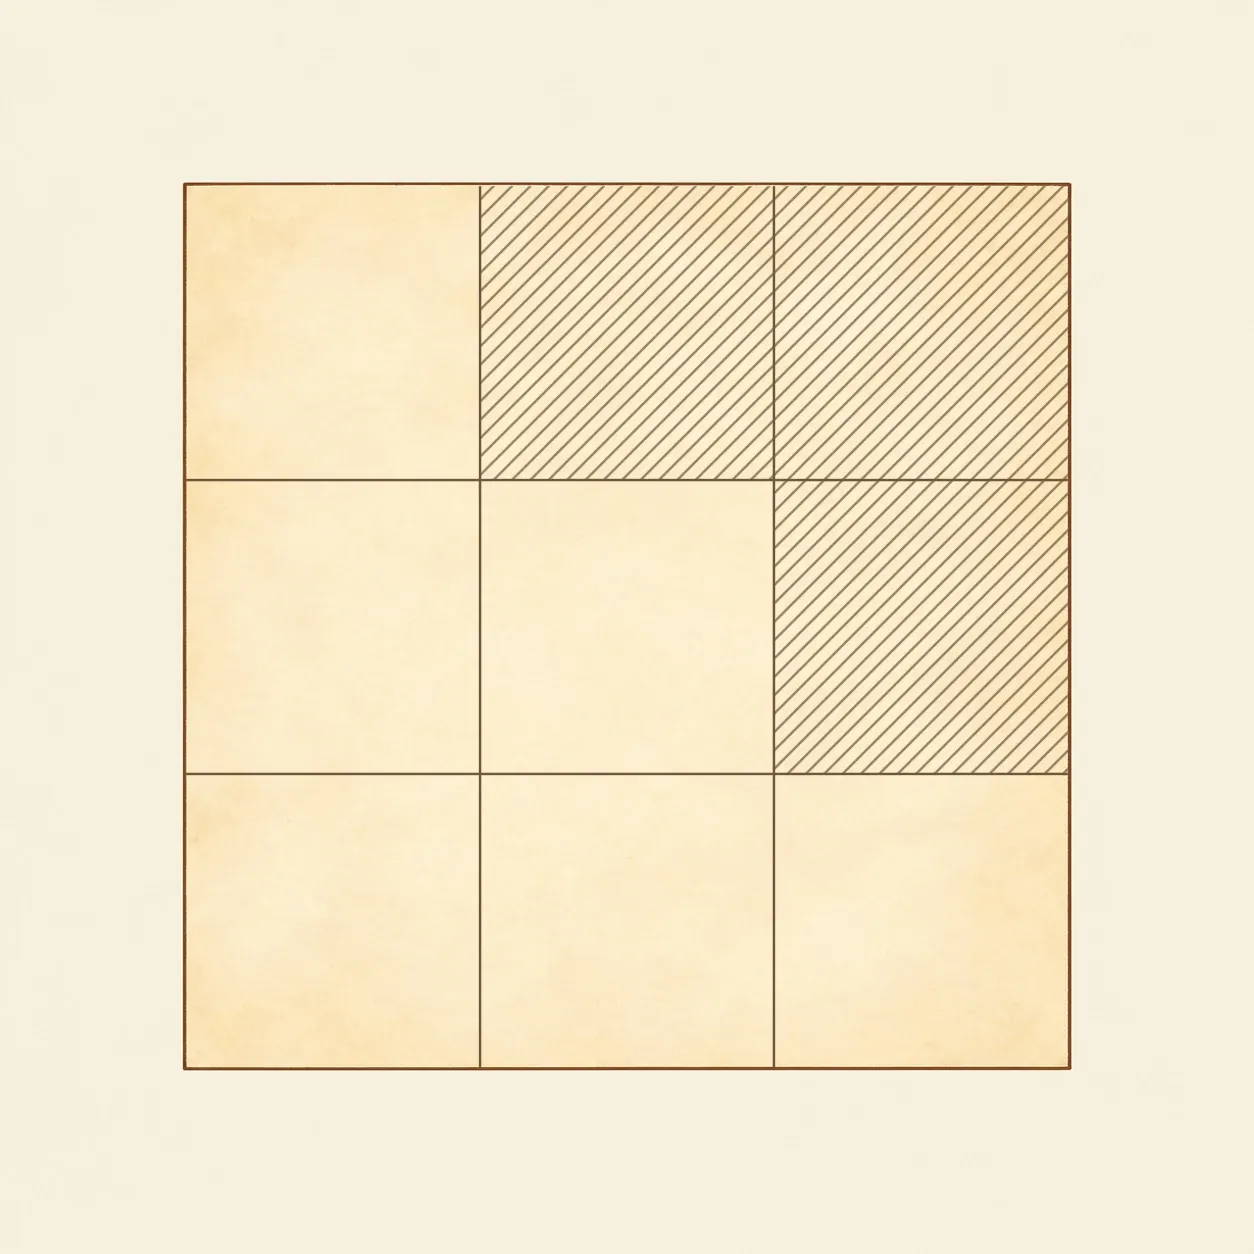 Uma máscara causal bloqueia as posições futuras acima da diagonal: as linhas são consultas e as colunas são chaves.
As pontuações são ln(3) e 0, pois a raiz quadrada de 1 é 1. As suas exponenciais valem 3 e 1, cuja soma é 4. Os pesos são, portanto, 3/4 e 1/4. A saída vale (3/4 × 2) + (1/4 × 6) = 3. O peso maior não elimina automaticamente a outra contribuição.
Repita o cálculo proibindo a segunda chave. Atribua à sua pontuação menos infinito antes do softmax: a sua exponencial passa a valer 0. Os pesos tornam-se 1 e 0 e a saída vale 2. Numa sequência, esta regra impede uma posição de consultar elementos seguintes. Uma máscara triangular mantém acessíveis a posição atual e as anteriores.
Treinar uma rede completa exige definir as representações, todas as camadas, os dados, o objetivo de aprendizagem e os ajustes dos parâmetros.
História e evolução
Bahdanau, Cho e Bengio propuseram em 2014 um mecanismo de alinhamento aprendido para tradução neuronal, apresentado na ICLR em 2015. O seu descodificador podia ponderar diferentes partes da frase de origem. A autoatenção também foi explorada antes do Transformer, como reconhece o artigo de 2017.
A 12 de junho de 2017, Vaswani e sete coautores depositaram Attention Is All You Need no arXiv. Construíram um codificador e um descodificador sem recorrência nem convolução para relacionar posições. O cálculo das representações permitia maior paralelismo, enquanto a geração autorregressiva continuava a produzir elementos sucessivamente.
Desenvolvimentos posteriores utilizam codificadores, descodificadores ou ambos para outras tarefas. Estas variantes alteram utilizações e treino. A arquitetura publicada em 2017 continua a ser o ponto de partida da família Transformer.